Label-free定量磷酸化蛋白组
产品概述
Label-free 定量磷酸化蛋白组技术是基于质谱一级峰面积信息进行磷酸化肽段在样品间的相对定量,而二级信息用于肽段序列的鉴。Label-free DDA定量磷酸化蛋白组技术与一般标记定量蛋白组技术比较,有以下特点:
不受样品标记数目限制
蛋白定量动态范围广
蛋白鉴定技术已广泛应用到动植物分子研究中,尤其是信号通路、激酶底物关系等,如:
转基因机理研究
环境胁迫机理研究
疾病机制研究

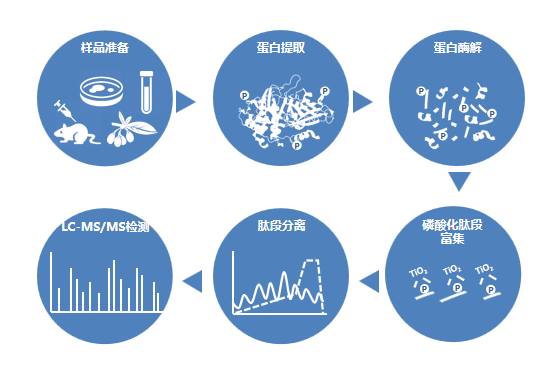
在实验方面,磷酸化蛋白检测主要包括蛋白提取、肽段酶解、磷酸化肽段富集和磷酸化肽段LC-MS/MS检测。实验的关键在于利用TiO2材料对磷酸化肽段进行富集
在信息分析方面,理论图谱库会在S、T和Y氨基酸上生成加入磷酸化修饰作为可变修饰,理论图谱库和实际磷酸化肽段检测的图谱进行匹配,通过磷酸化位点打分,最终得到可靠的磷酸化肽段鉴定结果。
蛋白组鉴定主要基于开源鉴定软件Maxquant定性分析。在磷酸化蛋白鉴定过程中,利用DeepQC进行整个磷酸化蛋白组检测的系统质控评估。鉴定得到的磷酸化蛋白,本分析会利用迪谱生物自主的功能数据库DeepFunction进行深度功能分析。
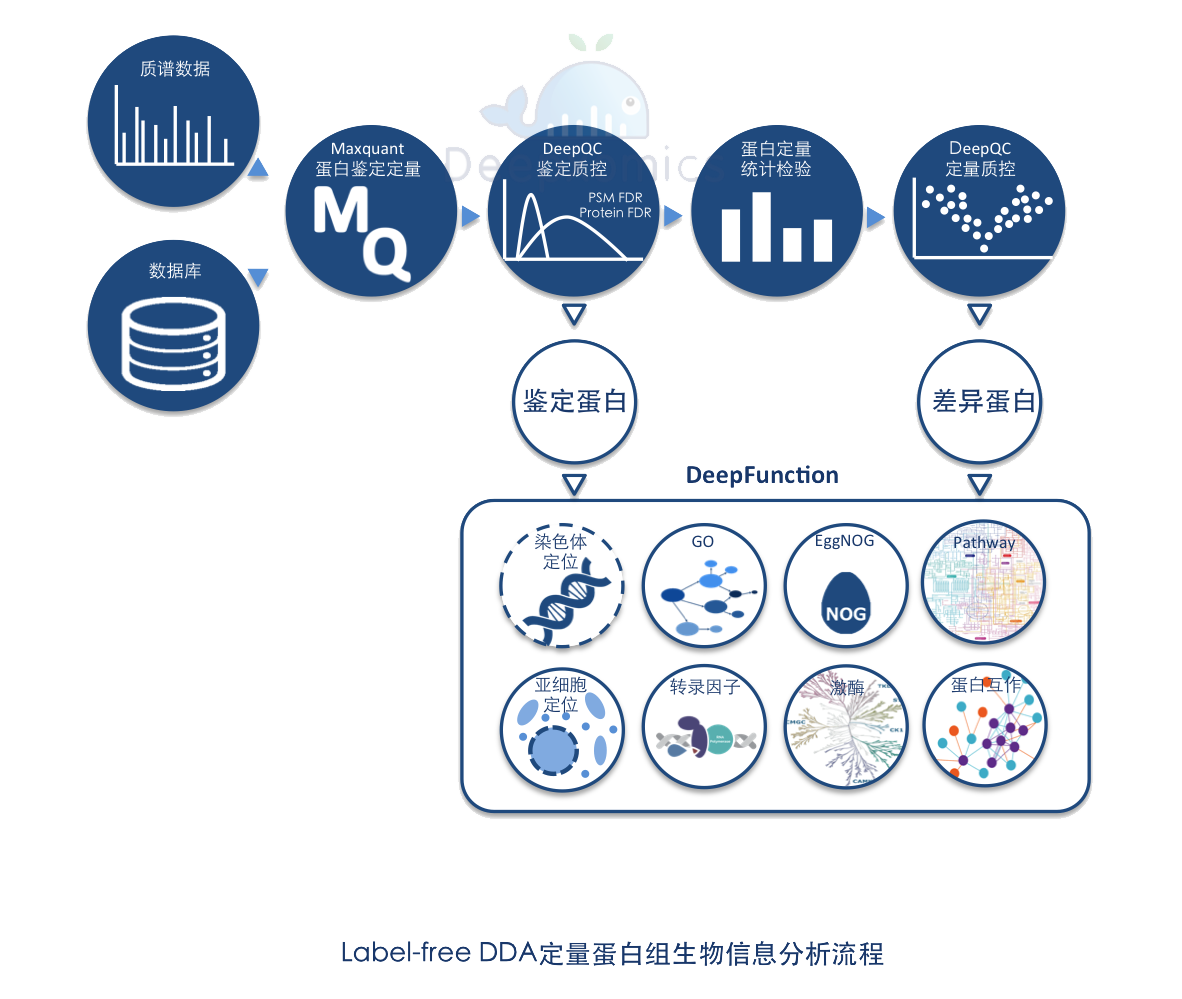
DeepQC质控控制
DeepQC主要对蛋白组数据进行鉴定与定量质控:
蛋白鉴定部分
1)蛋白提取质控
2)蛋白酶解质控
3)肽段标记质控
4)肽段分离质控
5)质谱检测质控
6)蛋白组鉴定整体质控

DeepFunction蛋白功能分析
DeepFunction主要对全部蛋白、差异蛋白两个层面进行深度功能分析:
全部蛋白
1)GO分析
2)Pathway分析
3)COG/KOG/EggNOG同源蛋白簇
4)亚细胞定位
5)转录因子分析
6)激酶分析
7)染色体定位(模式生物)
8)蛋白相互作用网络分析
研究目的
本产品针对样品数目较多的项目(大于等于8个样品),进行样品间蛋白组相对定量分析。
生物重复
生物重复是科学研究严谨性的重要保证。Label-free DDA定量蛋白组推荐每种类型样品设置大于等于3个生物重复。
样品量
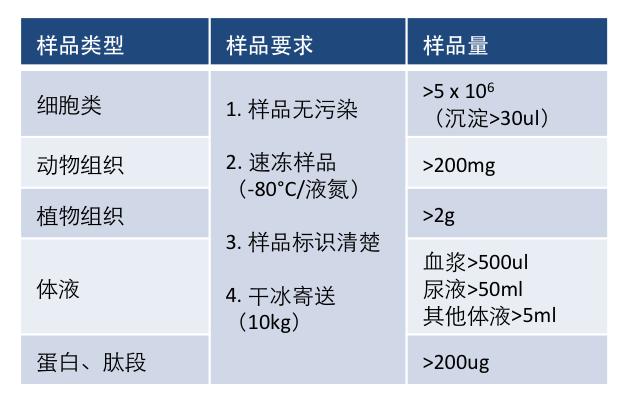
Label-free DDA定量蛋白组每次实验对每个样品一般需要200ug。充足的样品量可以预防实验失败,降低实验风险。下表为推荐样品量:
验证实验
一般高通量组学实验发现的差异蛋白需要进行验证实验,如转录组学后用qPCR技术进行验证。iTRAQ定量蛋白组学实验发现感兴趣的蛋白可以用靶向蛋白定量技术进行验证,如MRM、Westernblot等
蛋白序列数据库
蛋白序列数据库是目前蛋白组鉴定的基本,最终鉴定到的蛋白质序列都来源于被选择的数据库。
小迪推荐研究者目前蛋白组使用频率最高的三大类蛋白序列数据库:
1)UniProt蛋白数据库
UniProt是信息最丰富、资源最广的蛋白质数据库。它由整合Swiss-Prot、 TrEMBL 和 PIR-PSD 三大数据库的数据而成。它是经过专家校验的数据集,主要由两部分组成:UniProtKB/Swiss-Prot (包含检查过的、手工注释的条目) 和 UniProtKB/TrEMBL (包含未校验的、自动注释的条目)。一般情况下推荐优先使用UniProtKB/Swiss-Prot子集进行相应物种的蛋白质鉴定。当需要寻找新特征序列(如可变剪切,新转录本)或近源物种的鉴定时,才考虑加入UniProtKB/TrEMBL数据库。
2)基于基因组注释的蛋白数据库
主要包括NCBI和Ensembl两大基因注释系统衍生出的一系列数据库。
其中NCBI系统的主要选择参考序列(RefSeq)计划中的蛋白数据库,这是一个非冗余的蛋白质组数据库,由于NCBI注释系统的影响力,该类库广泛应用于多组学关联的分析当中。NCBI的参考序列计划(RefSeq)将为中心法则中自然存在的分子,从染色体到mRNA到蛋白提供参考序列标准。RefSeq标准为人类基因组的功能注解提供一个基础。它们为突变分析,基因表达研究,和多态发现提供一个稳定的参考点。
除此以外,NCBI还提供了非冗余蛋白质序列nr全库(non-redundant),包括动物、植物、微生物、细菌等分类。由于该数据库来源广泛(包含GeneBank,RefSeq,SwissProt,PDB等等),因此除非是基因组注释不完整的物种,抑或需要进行同源物种的搜索。否则不推荐直接利用该库进行蛋白鉴定。
Ensembl旨在开发一种能够对真核生物基因组进行自动注释(automatic annotation)并加以维护的软件。 Ensembl具有比较完整一致的基因组、转录组、蛋白质组注释信息。非常适合用于涉及多组学关联的分析。
3) 其它来源数据库
通常指客户提供的目标蛋白数据库,或者指基因组转组学测序产生并denovo组装完成的新基因序列。另外还可以包含一些新特征的序列,如可变剪切,突变位点,融合基因等等。
【案例】利用磷酸化蛋白组学鉴定血浆细胞外磷酸化蛋白
在癌症早期发生的时候,蛋白磷酸化在生命过程中起着重要的作用。当前对于癌症的磷酸化biomarker研究大多仅限于组织样品,这满足不了临床诊断的早检、无创等需求。该研究利用磷酸化蛋白组技术在血浆微创型临床材料上进行研究乳腺癌biomarker研究。挑选4个健康女性血浆和30个乳腺癌血浆样品,利用梯度离心搜集血浆的细胞外囊泡:微粒体和外泌体,分别进行蛋白酶解、磷酸化肽段富集LC-MS/MS检测。结果发现血浆这些细胞外囊破总共鉴定到约10,000条磷酸化肽段,其中微粒体有156个、外泌体有271个磷酸化位点发生差异表达。对这些差异磷酸化位点进行Motif、STRING等功能分析,发现与癌症转移、细胞膜识别、细胞间交流等功能有重要关系,尤其是SRC酪氨酸激酶。该研究还对比了CPTAC在乳腺癌组织的磷酸化蛋白研究数据,发现该研究的细胞外囊泡与组织的磷酸化有较大的差异。最后,挑选了7个差异磷酸化肽段利用PRM目标磷酸化肽段定量在新的13个病人和7个健康人得到成功的验证。

参考文献
Chen, I. H., Xue, L., Hsu, C. C., Paez, J. S. P., Pan, L., Andaluz, H., ... & Tao, W. A. (2017). Phosphoproteins in extracellular vesicles as candidate markers for breast cancer. Proceedings of the National Academy of Sciences, 201618088.
提问:物种没有基因组数据库,怎么办?
解答:如果该物种没有基因组,一方面可以测该样品的转录组,通过生物信息翻译蛋白参考序列。另外,可以寻找进化关系旁系的有基因组的物种,借助他们的基因组构建蛋白参考序列。前者方法比后者更为准确。